Gemma AI
Google · 12 min de lecture
- Gratuit
- Programmation
- Windows · Mac · Linux · API

Mon verdict
Informaticien depuis 2002 : systèmes, ingénierie, développement web et SEO. Je fais des affaires avec l’IA depuis février 2023, quand ChatGPT a pu s’acheter en Espagne.
Gemma 4 est une bonne porte d’entrée pour faire tourner chez soi une IA de Google : gratuite, sous licence Apache 2.0, installée en quelques minutes avec Ollama. La plus petite taille tient dans moins de 3 Go de mémoire et m’a répondu dans un français correct, sans carte graphique. Mais elle se trompe sur des faits simples, surtout avec le mode réflexion : donnez-lui des textes à travailler plutôt que des questions de culture générale.
Qu’est-ce que Gemma AI
- Entreprise
- Type
- Programmation
- Plateformes
- Windows · Mac · Linux · API
- Offre gratuite
- Gratuit
- Mis à jour le
- 23 oct. 2026
Gemma, c’est la famille de modèles d’IA ouverts de Google. La génération actuelle, Gemma 4, se télécharge gratuitement, peut même servir dans un projet commercial (licence Apache 2.0) et tourne sur votre propre ordinateur, sans abonnement. Ce n’est pas un assistant comme Gemini : c’est le « moteur » que vous installez chez vous, décliné en cinq tailles, de la petite E2B, qui tient dans moins de 3 Go de mémoire, à la 31B, qui réclame une grosse carte graphique. J’ai installé la plus petite sur un serveur Linux sans carte graphique et je l’ai fait travailler en français : voici ce qui marche, ce qui coince, et quelle taille choisir.
Ce qu’est Gemma aujourd’hui
Gemma est née en 2024 avec deux petits modèles, de 2 et 7 milliards de paramètres. La génération actuelle, Gemma 4, est sortie fin mars 2026, et Google l’a complétée en juin avec une taille intermédiaire, la 12B. Elle est bâtie sur la même technologie que Gemini, avec une différence majeure : Google publie les « poids » du modèle, c’est-à-dire le modèle lui-même, que vous téléchargez et faites tourner où vous voulez. Pardon pour le jargon, mais c’est tout l’intérêt de Gemma.
Selon sa fiche technique, Gemma 4 comprend le texte et les images dans toutes ses tailles, la vidéo aussi, et l’audio dans les trois plus petites. Elle a un mode « réflexion » que l’on peut activer ou couper, traite jusqu’à 128 000 tokens de contexte (des morceaux de mots) dans les petites tailles et 256 000 dans les autres, et a été entraînée sur plus de 140 langues, selon Google.
Autre changement qui compte : Gemma 4 est sous licence Apache 2.0, une licence libre classique qui autorise l’usage commercial, la modification et la redistribution. Les générations précédentes restent soumises à leurs propres conditions d’utilisation, rédigées par Google. Autour du modèle principal gravitent des variantes spécialisées (EmbeddingGemma, ShieldGemma, PaliGemma, Gemma 3n…), et même DolphinGemma, qui s’intéresse au langage des dauphins. Si vous débutez, ignorez-les : c’est Gemma 4 qu’il vous faut.
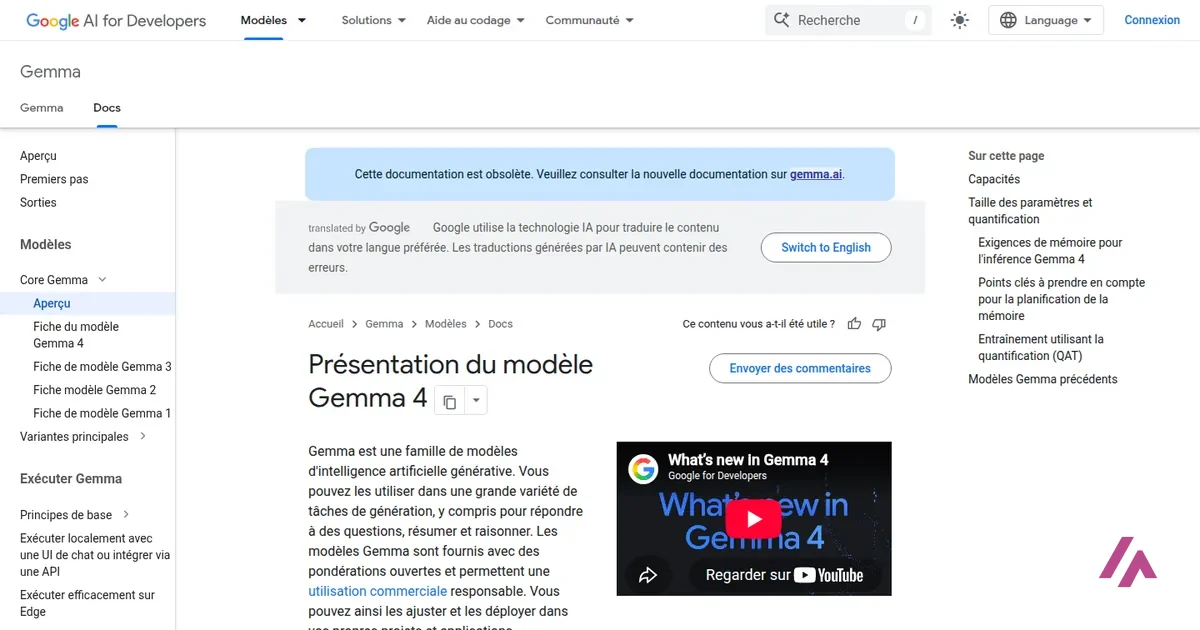
La documentation officielle a déménagé sur gemma.ai, en anglais. L’ancienne, sur le site Google AI for Developers, existe en français, traduite automatiquement, mais affiche désormais un bandeau qui renvoie vers la nouvelle.
Quelle taille de Gemma 4 choisir
| Taille | Ce que c’est | Mémoire en 4 bits (selon Google) | Pour quelle machine |
|---|---|---|---|
| E2B | La plus petite : environ 2 milliards de paramètres « effectifs », texte, images et audio, 128 000 tokens | 2,9 Go | Un ordinateur modeste, un téléphone, un serveur sans carte graphique (la taille de mon test) |
| E4B | Environ 4 milliards de paramètres effectifs, texte, images et audio, 128 000 tokens | 4,5 Go | Un ordinateur récent : c’est la taille qu’Ollama installe si vous ne précisez rien |
| 12B | 12 milliards de paramètres, texte, images et audio, 256 000 tokens | 6,7 Go | Une carte graphique grand public avec assez de mémoire |
| 26B A4B | Un « mélange d’experts » de 26 milliards de paramètres, qui n’en active que 4 milliards à chaque token, 256 000 tokens | 14,4 Go | Rapide pour sa taille, mais il faut la mémoire d’un modèle de 26 milliards |
| 31B | La plus grande et la plus capable, 256 000 tokens | 17,5 Go | Une grosse carte graphique ou une station de travail |
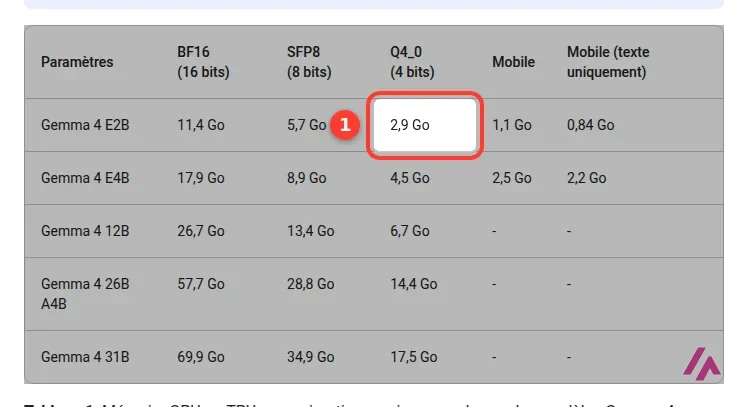
Mon conseil : commencez par la E4B si votre ordinateur a de la marge, par la E2B s’il est modeste, et ne passez à la 12B ou au-delà que si vous avez une carte graphique avec assez de mémoire. Les « E » veulent dire « effectifs » : ces petites tailles embarquent davantage de paramètres qu’elles n’en font travailler, grâce à une astuce d’architecture.
Les Go du tableau, c’est le modèle seul (Attention)
Google prévient que ces chiffres ne comptent que les poids du modèle : la conversation elle-même consomme de la mémoire en plus, et d’autant plus que les textes sont longs. Et le téléchargement pèse plus lourd que ce qu’indique le tableau : chez moi, la E2B d’Ollama faisait un peu moins de 5 Go sur le disque. Autre détail : Ollama ne gère que le texte et les images de Gemma 4 ; pour l’audio, la documentation renvoie vers d’autres outils, comme Transformers ou llama.cpp.
Gemma est-elle gratuite ?
Oui. Les modèles se téléchargent sans payer, sur Kaggle, sur Hugging Face ou directement avec Ollama, et la licence Apache 2.0 vous laisse en faire ce que vous voulez, y compris un produit que vous vendez. La seule facture, c’est votre matériel et votre électricité.
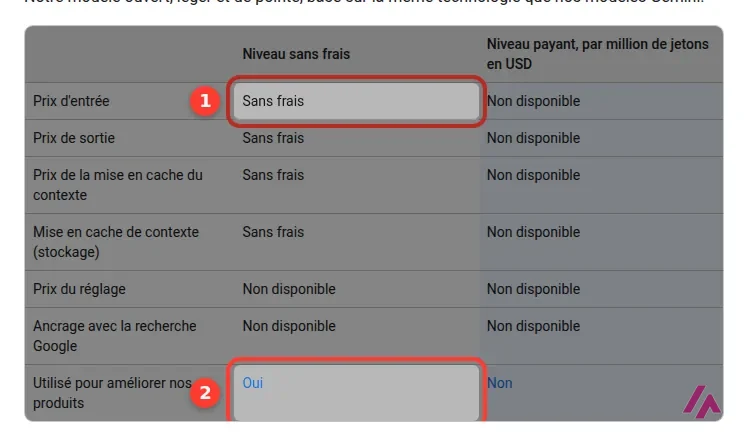
Si vous préférez ne rien installer, Google propose aussi Gemma 4 dans son API Gemini, et la page des tarifs le dit clairement : Gemma 4 est sans frais, et il n’existe pas de niveau payant pour ce modèle. Il y a une contrepartie : dans ce niveau sans frais, ce que vous envoyez est « utilisé pour améliorer nos produits ». En local, la question ne se pose pas : vos textes restent sur votre machine. Pour l’essayer dans le navigateur, il y a aussi Google AI Studio, réservé aux plus de 18 ans et accessible avec un compte Google.
Installer Gemma en local, pas à pas
C’est ce que j’ai fait avec Ollama, un petit logiciel gratuit qui télécharge les modèles et les fait tourner, en ligne de commande. Si le terminal vous rebute, LM Studio fait la même chose avec une interface graphique.
- Installez Ollama depuis ollama.com/download. Sous Linux, je l’ai fait sans droits d’administrateur, en décompressant l’archive officielle dans mon dossier personnel.
- Lancez-le : l’application sur PC ou Mac, ou
ollama servedans un terminal. - Téléchargez une taille avec
ollama pull gemma4:e2b(oue4b,12b,26b,31b). Sans précision,gemma4installe la E4B. - Posez votre question :
ollama run gemma4:e2bsuivi de votre demande entre guillemets, ouollama run gemma4:e2btout court pour discuter. - Coupez la réflexion si besoin en ajoutant
--think=false: sur une question simple, c’est plus rapide, et dans mon test, c’était même plus juste. - Faites de la place quand vous aurez fini :
ollama rm gemma4:e2befface le modèle.
Mon test : Gemma 4 E2B en français, sans carte graphique
Je l’ai fait tourner sur un serveur Linux, en la limitant à 8 cœurs pour ne pas gêner le reste. Une fois chargée, la E2B occupait moins de 3 Go de mémoire vive. Elle écrit quelques mots par seconde : une réponse courte arrive en une dizaine de secondes, un e-mail en un peu plus d’une minute.
Première question, avec les réglages par défaut : les préfectures de l’Aveyron, de la Haute-Loire et de la Creuse. Gemma s’est d’abord mise à « réfléchir »… en anglais, a conclu toute seule que je demandais en fait le nom des départements, et m’a répondu « Préfecture de l’Aveyron : Aveyron ». Faux sur toute la ligne.
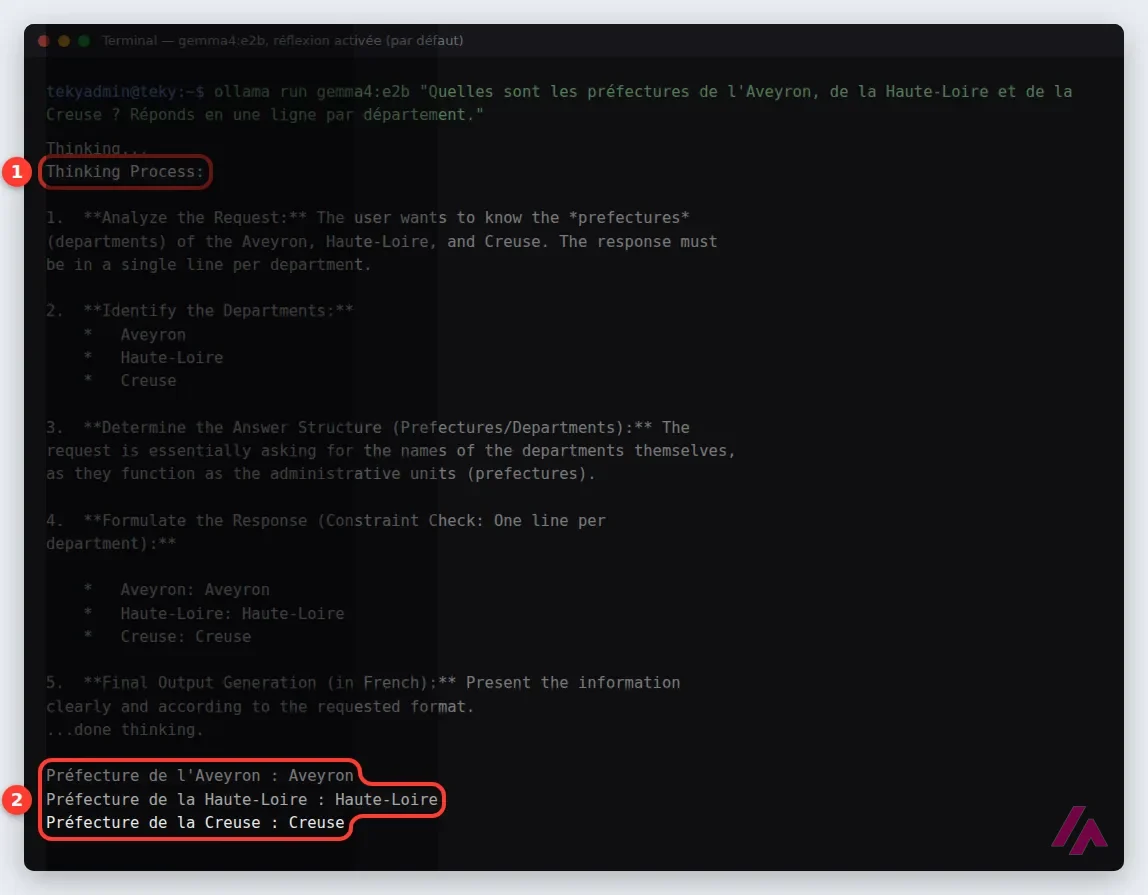
La même question, réflexion coupée (--think=false) : Rodez, Le Puy-en-Velay et Guéret. Sans faute, en dix secondes, avec une petite maladresse de français au passage : « Préfecture de Le Puy-en-Velay » au lieu de « du Puy-en-Velay ».
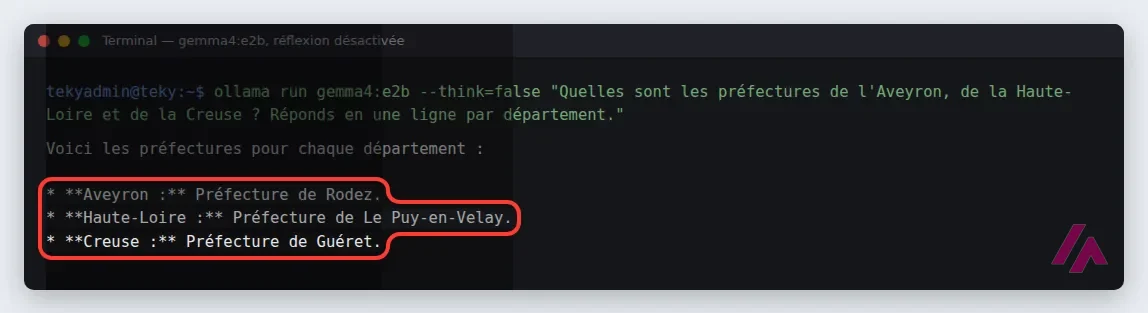
La réflexion ne rend pas toujours plus malin (Attention)
Sur ma question de géographie, le mode réflexion, activé par défaut dans Ollama, a fait pire que la réponse directe, en prenant bien plus de temps. Sur une petite taille comme la E2B, essayez les deux avant de vous faire une idée, et ne tenez jamais un fait pour acquis sans l’avoir vérifié.
Le résumé d’un paragraphe sur le canal du Midi, en deux phrases : réussi. Il a gardé l’essentiel (Toulouse, l’étang de Thau, le XVIIe siècle, les 240 kilomètres, la plaisance, l’UNESCO), sacrifié Riquet et les écluses, et n’a rien inventé.
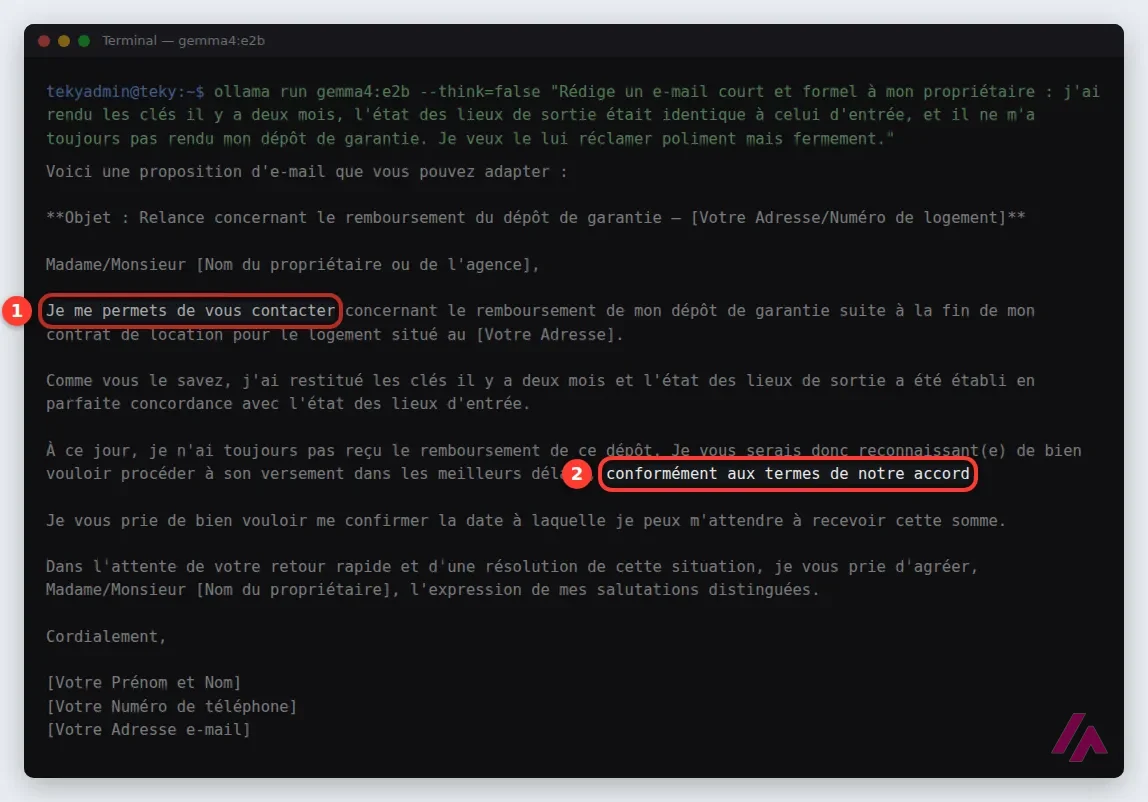
L’e-mail formel à un propriétaire qui ne rend pas le dépôt de garantie deux mois après la remise des clés : un français propre, le bon registre, des crochets à remplir et même trois conseils avant l’envoi. Mais pour un courrier « ferme », il manque l’argument principal : pas un mot du délai légal de restitution (un mois quand l’état des lieux de sortie est conforme à celui d’entrée), seulement un vague « conformément aux termes de notre accord ». Et il se termine deux fois : « salutations distinguées » puis « Cordialement ».
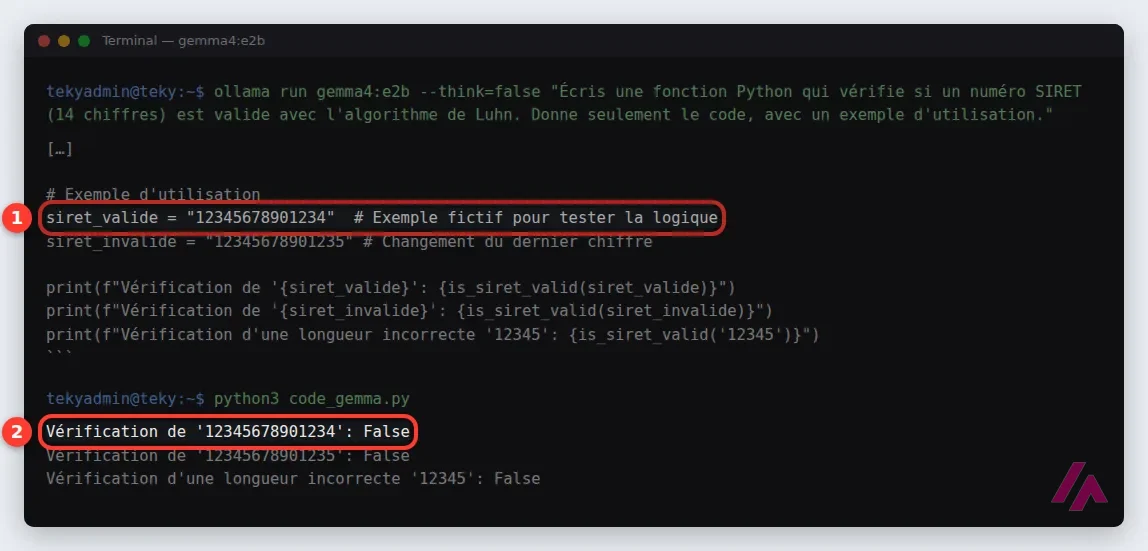
Le code : une fonction Python qui vérifie un numéro SIRET de 14 chiffres avec l’algorithme de Luhn. La fonction est juste : je l’ai exécutée avec un numéro valide que j’avais construit, puis avec le même numéro modifié, et elle a répondu correctement les deux fois. En revanche, l’exemple que Gemma fournit comme « valide » ne l’est pas, et son propre script affiche « False ». Elle refuse aussi un SIRET écrit avec des espaces, alors qu’on l’écrit souvent ainsi.
Donnez-lui un texte, pas un quiz (Conseil)
La petite taille de Gemma brille quand elle travaille sur ce que vous lui donnez : résumer, reformuler, rédiger un brouillon. Elle a trébuché quand elle devait tirer un fait de sa mémoire. Pour un usage de tous les jours en local, confiez-lui vos textes, et relisez ce qui ressemble à un fait ou à une règle.
Gemma ou Gemini : quelle différence ?
Les deux viennent de Google et partagent la même technologie, mais ils ne servent pas à la même chose.
| Gemma | Gemini | |
|---|---|---|
| Ce que c’est | Un modèle à télécharger | Un assistant prêt à l’emploi, sur le web et sur mobile |
| Où il tourne | Sur votre ordinateur ou votre serveur | Dans le cloud de Google |
| Compte | Aucun avec Ollama | Utilisable sans compte, plus de fonctions avec un compte Google |
| Prix | Gratuit | Gratuit, avec des formules payantes |
| Vos textes | Restent chez vous | Partent chez Google |
| Pour qui | Développeurs, curieux, projets sensibles | Tout le monde |
Si vous voulez simplement poser des questions, rédiger ou chercher sur le web, prenez Gemini, l’assistant de Google : il cherche sur le web, alors que les données d’entraînement de Gemma 4 s’arrêtent en janvier 2025, selon sa fiche technique. Gemma devient intéressante quand vous voulez une IA hors ligne, intégrée à votre propre logiciel, ou qui ne voit jamais passer vos documents.

Les autres modèles ouverts à essayer
Gemma n’est pas seule sur ce terrain, et selon la tâche, un autre peut faire mieux : l’idéal reste d’en essayer deux sur vos propres textes.
Qwen, d’Alibaba, publie une bonne partie de ses modèles sur Hugging Face, avec des licences qui varient d’un modèle à l’autre : lisez celle du modèle choisi avant de vous lancer. Son chat en ligne permet de l’essayer sans rien installer.
DeepSeek est surtout connu pour son assistant gratuit, mais on peut aussi faire tourner ses modèles chez soi : tout est expliqué dans le guide pour exécuter DeepSeek R1 en local.
Côté français, Mistral AI publie aussi des modèles ouverts, comme Mistral Small 3.1, qui tourne sur une seule carte graphique RTX 4090 ou sur un Mac avec 32 Go de mémoire.
Testé et rédigé par Miguel Ángel, avec l’aide d’un LLM pour vérifier les données.
La présentation officielle de Gemma 4, en anglais et en moins de trois minutes : la famille de modèles, puis des démonstrations sur téléphone et sur ordinateur portable.
Pour qui ? Pour les développeurs, les curieux et tous ceux qui veulent une IA qui tourne sur leur propre ordinateur, sans abonnement et sans envoyer leurs textes dans le cloud. Si vous voulez simplement discuter avec une IA de Google, Gemini, prêt à l’emploi, vous conviendra mieux.
Ce qui me plaît et ce qui me plaît moins
Ce qui me plaît
- Gratuite et sous licence Apache 2.0 : vous pouvez l’utiliser dans un projet commercial, la modifier et la redistribuer.
- Cinq tailles, de la petite E2B (moins de 3 Go en 4 bits selon Google) à la 31B, toutes capables de comprendre les images, et l’audio pour les trois plus petites.
- Installée en quelques minutes avec Ollama, sans compte, et vos textes ne quittent pas votre machine.
Ce qui me plaît moins
- La petite taille peut se tromper sur des faits simples : avec la réflexion activée, elle m’a donné le nom du département au lieu de sa préfecture.
- Dans mon test, avec les réglages par défaut, elle a « réfléchi » en anglais avant de répondre en français, et l’attente s’est allongée d’autant.
- Sans carte graphique, les longues réponses prennent une à deux minutes, et les grandes tailles réclament une machine sérieuse.
Vous avez utilisé Gemma AI ? Racontez-moi
Ce qui a marché et ce qui n’a pas marché. Votre expérience aidera le prochain lecteur qui hésite plus que n’importe quelle fiche. Je les relis toutes avant publication.
Écrire mon avis
Prix de Gemma AI
Prix vérifiés sur le site officiel le · TVA incluse
-
Gratuit
Gratuit
—
Alternatives à Gemma AI
-
Qwen
Gratuit
Quand la choisir: Si vous voulez une autre grande famille de modèles ouverts, publiée en partie sur Hugging Face, avec un chat pour l’essayer avant d’installer quoi que ce soit.
Voir la fiche → -
DeepSeek
Gratuit
Quand la choisir: Si vous voulez un autre modèle à faire tourner en local, ou un assistant gratuit en ligne.
Voir la fiche → -
MistralSmall3.1 IA
Quand la choisir: Si vous préférez un modèle ouvert d’une entreprise française, qui tourne sur une seule carte graphique haut de gamme.
Voir la fiche →
Comment je l’ai testé
Le 23 octobre 2026, j’ai lu la documentation officielle de Gemma (en anglais et dans sa traduction française), la fiche technique de Gemma 4 et la page des tarifs de l’API Gemini. Ensuite, j’ai installé Ollama depuis son archive officielle sur un serveur Linux sans carte graphique, limité à 8 cœurs, et j’y ai téléchargé Gemma 4 E2B, la plus petite taille. Je lui ai donné quatre tâches en français : une question de géographie (avec puis sans le mode réflexion), le résumé d’un paragraphe, un e-mail formel à un propriétaire et une fonction Python, que j’ai ensuite exécutée. Puis j’ai supprimé le modèle. Miguel Ángel, avec l’aide d’un LLM pour vérifier les données.
En français : le vidéaste montre comment installer Gemma 4 12B sur un PC pour la faire tourner en local, sans passer par le cloud.

Écrit par Miguel Ángel, avec l’aide d’un LLM pour vérifier les données. Informaticien depuis 2002 (systèmes, ingénierie, développement web et SEO), je fais des affaires avec l’IA depuis février 2023, quand ChatGPT a pu s’acheter en Espagne. J’écris et je maintiens ce site moi-même.

Une question ? Posez-la-moi
Sur Gemma AI, ses offres ou si c’est l’outil qu’il vous faut. C’est moi, Miguel Ángel, qui vous réponds, ici même.